
Tin Công Nghệ
Hạ Tầng AI 2026–2030: GPU, Bộ Nhớ HBM Và Mạng Tốc Độ Cao Sẽ Thay Đổi Điều Gì?
Trong giai đoạn 2026–2030, sự phát triển của GPU, bộ nhớ băng thông cao HBM và công nghệ mạng tốc độ cao được dự báo sẽ định hình lại kiến trúc AI Server và Data Center. Thay vì chỉ tập trung nâng cấp sức mạnh xử lý, các hệ thống AI sẽ cần tối ưu đồng thời khả năng tính toán, truy cập bộ nhớ, truyền dữ liệu và tiêu thụ năng lượng.
Điều này đặt ra một câu hỏi quan trọng: Doanh nghiệp sẽ cần thay đổi cách thiết kế và đầu tư hạ tầng AI như thế nào để đáp ứng nhu cầu trong những năm tới?
Hạ tầng AI đang thay đổi như thế nào trong giai đoạn 2026–2030?
Hạ tầng AI là tập hợp các tài nguyên phần cứng, phần mềm, mạng và lưu trữ được xây dựng để phát triển, huấn luyện, triển khai và vận hành ứng dụng trí tuệ nhân tạo.
Một hệ thống AI hiện đại có thể bao gồm GPU hoặc bộ tăng tốc AI chuyên dụng, CPU, bộ nhớ, hệ thống lưu trữ tốc độ cao, mạng kết nối giữa các máy chủ cùng nền tảng phần mềm quản lý.
Trước đây, hiệu năng tính toán thường được xem là yếu tố quan trọng nhất khi lựa chọn phần cứng AI. Tuy nhiên, sự phát triển của các mô hình AI lớn đã làm thay đổi cách đánh giá hiệu quả của một hệ thống.
Từ hiệu năng GPU đơn lẻ sang hiệu năng toàn hệ thống
Một GPU mạnh có thể xử lý nhanh các phép toán AI. Tuy nhiên, khi triển khai mô hình trên nhiều GPU, hiệu năng thực tế còn phụ thuộc vào tốc độ truy cập bộ nhớ và khả năng trao đổi dữ liệu giữa các bộ xử lý.
Nếu GPU có khả năng tính toán cao nhưng phải chờ dữ liệu từ bộ nhớ hoặc mạng, một phần năng lực xử lý sẽ không được khai thác hiệu quả.
Vì vậy, các nhà sản xuất đang chuyển sang phát triển nền tảng tính toán tích hợp, trong đó GPU, bộ nhớ, kết nối mạng và phần mềm được thiết kế đồng bộ.
AI Training và AI Inference cùng thúc đẩy nhu cầu hạ tầng
Hai nhóm tác vụ chính tiếp tục ảnh hưởng đến thiết kế hạ tầng AI:
AI Training: Huấn luyện hoặc tinh chỉnh mô hình, thường đòi hỏi khả năng tính toán song song và trao đổi dữ liệu lớn giữa các GPU.
AI Inference: Sử dụng mô hình đã huấn luyện để xử lý yêu cầu thực tế, cần cân bằng thông lượng, độ trễ, dung lượng bộ nhớ và chi phí phục vụ.
Đặc biệt, AI Agent có thể thực hiện nhiều bước suy luận liên tiếp, truy xuất dữ liệu và sử dụng công cụ để hoàn thành một nhiệm vụ. Điều này làm tăng yêu cầu đối với khả năng xử lý liên tục và quản lý bộ nhớ của hệ thống.
GPU AI sẽ phát triển theo hướng nào đến năm 2030?
GPU tiếp tục là một trong những thành phần quan trọng nhất của hạ tầng AI. Tuy nhiên, cuộc cạnh tranh GPU trong giai đoạn 2026–2030 không chỉ tập trung vào số lượng phép toán mà bộ xử lý có thể thực hiện mỗi giây.
Các nhà sản xuất đang tập trung đồng thời vào hiệu quả suy luận, dung lượng bộ nhớ, khả năng kết nối nhiều GPU và hiệu năng trên mỗi watt điện.
GPU ngày càng được tối ưu cho LLM và Generative AI
LLM và Generative AI sử dụng lượng lớn phép toán ma trận, đặc biệt trong quá trình huấn luyện và suy luận.
Những GPU AI chuyên dụng được thiết kế với các khối xử lý tăng tốc tensor, hỗ trợ nhiều định dạng dữ liệu như FP16, BF16, FP8 và FP4 tùy theo kiến trúc.
Việc sử dụng những định dạng có độ chính xác thấp hơn trong các mô hình phù hợp có thể giảm nhu cầu bộ nhớ, cải thiện thông lượng và tăng hiệu quả sử dụng tài nguyên tính toán.
Chẳng hạn, các nền tảng NVIDIA Blackwell và Rubin hỗ trợ tính toán AI với độ chính xác thấp, phục vụ những tác vụ suy luận có nhu cầu xử lý lớn.
Từ GPU Server đến hệ thống AI quy mô rack
Một thay đổi đáng chú ý là sự xuất hiện của các nền tảng AI được thiết kế ở quy mô rack.
Thay vì kết nối nhiều máy chủ GPU độc lập theo cách truyền thống, hệ thống rack-scale tích hợp GPU, CPU, kết nối nội bộ, nguồn điện và làm mát thành một kiến trúc phối hợp.
Hai ví dụ tiêu biểu trong năm 2026 gồm:
NVIDIA Vera Rubin NVL72: Kết hợp 72 GPU Rubin thông qua NVLink 6, hỗ trợ các tác vụ AI cần kết nối nhiều GPU với băng thông cao.
AMD Helios: Kiến trúc rack-scale sử dụng GPU AMD Instinct MI400 Series, hướng đến các hệ thống AI quy mô lớn với thiết kế dựa trên nhiều tiêu chuẩn mở.
Đây là các nền tảng có định hướng khác nhau, nhưng cùng phản ánh xu hướng chuyển từ việc tối ưu từng GPU sang tối ưu toàn bộ hệ thống tính toán.
Bộ nhớ HBM: Yếu tố quyết định khả năng khai thác hiệu năng GPU
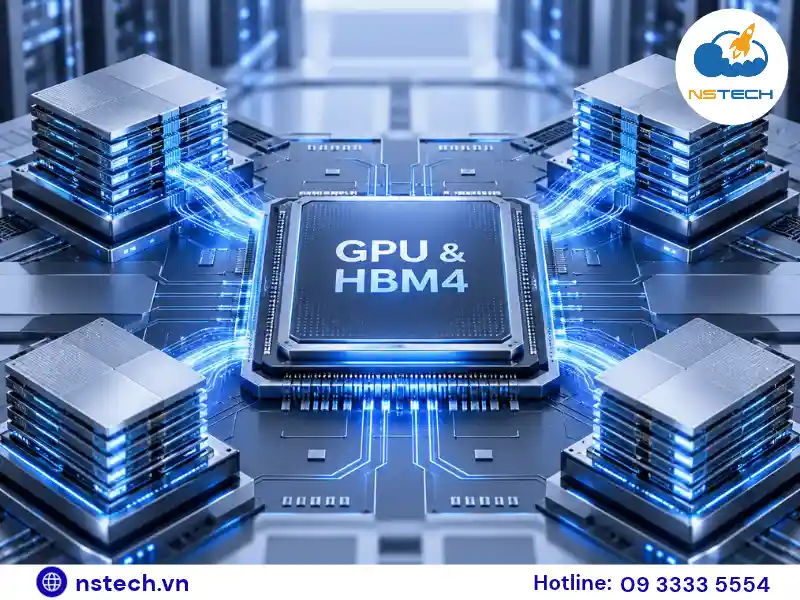
Nếu GPU đảm nhiệm việc tính toán, bộ nhớ HBM đóng vai trò cung cấp dữ liệu với tốc độ cao để GPU xử lý.
Khi kích thước mô hình AI và nhu cầu suy luận tăng lên, bộ nhớ trở thành một trong những yếu tố có ảnh hưởng lớn đến hiệu năng toàn hệ thống.
Bộ nhớ HBM là gì?
HBM (High Bandwidth Memory) là công nghệ bộ nhớ băng thông cao, sử dụng nhiều lớp DRAM xếp chồng và kết nối thông qua công nghệ TSV (Through-Silicon Via).
So với những giải pháp bộ nhớ đồ họa thông thường, HBM được thiết kế để cung cấp băng thông lớn trong một cấu trúc tích hợp gần bộ xử lý.
HBM đặc biệt phù hợp với GPU AI và các bộ tăng tốc chuyên dụng cần truy cập lượng dữ liệu lớn trong thời gian ngắn.
Trong một hệ thống AI, HBM có thể lưu trữ trọng số mô hình, dữ liệu trung gian và KV Cache phục vụ quá trình suy luận.
Mạng tốc độ cao sẽ trở thành nền tảng kết nối các hệ thống AI
Khi hạ tầng AI mở rộng từ một GPU lên nhiều GPU, nhiều máy chủ hoặc nhiều rack, hệ thống mạng bắt đầu ảnh hưởng trực tiếp đến hiệu quả xử lý.
Một cụm AI có thể sở hữu nhiều GPU mạnh nhưng không khai thác được toàn bộ năng lực tính toán nếu tốc độ truyền dữ liệu giữa các thiết bị không đáp ứng nhu cầu.
Ethernet 400G, 800G và các công nghệ kết nối AI
Các thế hệ Ethernet tốc độ cao đang được sử dụng và phát triển để phục vụ những hệ thống mạng trung tâm dữ liệu có nhu cầu băng thông lớn.
Đối với AI, mạng Ethernet được tối ưu có thể hỗ trợ truyền dữ liệu giữa máy chủ, hệ thống lưu trữ và các node GPU.
NVIDIA Spectrum-X là một ví dụ về giải pháp Ethernet được thiết kế cho AI, kết hợp switch, NIC và các cơ chế điều phối lưu lượng nhằm cải thiện khả năng vận hành cụm GPU.
Trong kiến trúc Spectrum-X, NVIDIA đã công bố các thế hệ switch và NIC hỗ trợ kết nối 800 Gb/s, đồng thời tiếp tục phát triển các giải pháp có tổng băng thông lớn hơn.
Tuy nhiên, doanh nghiệp không nhất thiết phải sử dụng Ethernet 400G hoặc 800G cho mọi ứng dụng AI. Băng thông cần thiết phụ thuộc vào số lượng node, lưu lượng trao đổi dữ liệu và kiến trúc hệ thống.
NVLink và InfiniBand khác gì Ethernet?
Ba công nghệ thường được nhắc đến trong hạ tầng AI gồm NVLink, InfiniBand và Ethernet.
| Công nghệ | Vai trò chính | Trường hợp sử dụng |
|---|---|---|
| NVIDIA NVLink/NVSwitch | Kết nối GPU tốc độ cao trong miền scale-up | Nhiều GPU phối hợp xử lý mô hình |
| InfiniBand | Mạng hiệu năng cao giữa các node | Huấn luyện phân tán, HPC, cụm AI lớn |
| Ethernet tối ưu cho AI | Kết nối mạng giữa các node và hệ thống lưu trữ | AI cluster, Data Center và hạ tầng đa nhà cung cấp |
NVLink chủ yếu phục vụ giao tiếp tốc độ cao giữa GPU trong phạm vi kiến trúc được hỗ trợ. Trong khi đó, InfiniBand và Ethernet có thể kết nối các máy chủ hoặc rack thành một cụm tính toán lớn hơn.
Mạng quang và Silicon Photonics sẽ có vai trò lớn hơn
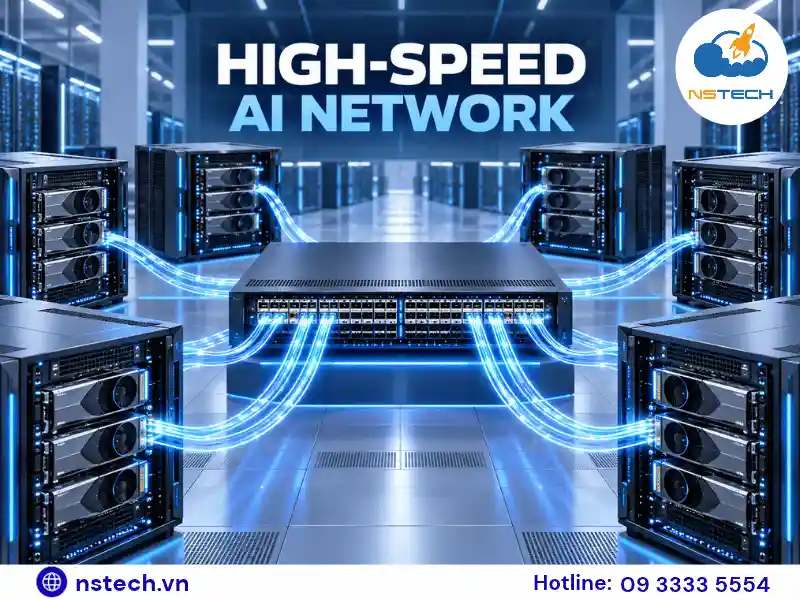
Khi quy mô AI Data Center tăng lên, số lượng cổng mạng, cáp và thiết bị truyền dẫn cũng gia tăng.
Điều này tạo áp lực lên điện năng tiêu thụ, mật độ kết nối và khả năng bảo trì.
Silicon Photonics là hướng phát triển sử dụng công nghệ quang tích hợp để hỗ trợ truyền dữ liệu tốc độ cao.
Đáng chú ý, các giải pháp Co-Packaged Optics (CPO) tích hợp thành phần quang gần chip chuyển mạch hơn, nhằm cải thiện hiệu quả truyền tín hiệu và tiêu thụ năng lượng ở quy mô lớn.
NVIDIA đã công bố các hệ thống Spectrum-X Ethernet Photonics sử dụng công nghệ này, thể hiện sự chuyển dịch của hạ tầng mạng AI sang những kiến trúc tích hợp sâu hơn giữa điện tử và quang học.
Đến năm 2030, công nghệ quang tích hợp có khả năng đóng vai trò ngày càng quan trọng đối với những cụm AI có mật độ kết nối rất cao. Tuy nhiên, thời điểm triển khai rộng rãi sẽ phụ thuộc vào chi phí, khả năng sản xuất, tiêu chuẩn và yêu cầu vận hành.
Sự kết hợp GPU, HBM và mạng tốc độ cao sẽ thay đổi điều gì?
Ba công nghệ này không phát triển độc lập mà có mối liên hệ trực tiếp trong hoạt động của một hệ thống AI.
GPU thực hiện tính toán, HBM cung cấp dữ liệu cho GPU, còn mạng tốc độ cao giúp nhiều bộ xử lý và máy chủ phối hợp thực hiện tác vụ.
Khi cả ba thành phần được tối ưu, hiệu năng hệ thống có thể được cải thiện theo những cách mà việc chỉ nâng cấp GPU không thể đạt được.
Thay đổi 1: Mở rộng khả năng xử lý những mô hình AI phức tạp
GPU có năng lực tính toán cao kết hợp với bộ nhớ dung lượng lớn giúp các hệ thống AI xử lý những mô hình có quy mô và nhu cầu bộ nhớ cao hơn.
Khi bổ sung kết nối tốc độ cao, doanh nghiệp có thể triển khai mô hình trên nhiều GPU hoặc nhiều máy chủ.
Điều này đặc biệt quan trọng đối với các dự án LLM, Generative AI và nghiên cứu mô hình chuyên ngành.
Thay đổi 2: Cải thiện hiệu quả suy luận AI
Đối với hệ thống AI Inference, hiệu quả không chỉ được đánh giá theo tốc độ xử lý một truy vấn mà còn phụ thuộc vào khả năng phục vụ nhiều yêu cầu cùng lúc.
HBM dung lượng lớn có thể hỗ trợ lưu trữ trọng số mô hình và KV Cache, trong khi băng thông bộ nhớ cao giúp giảm một số điểm nghẽn truy cập dữ liệu.
Kết hợp với GPU và phần mềm suy luận được tối ưu, doanh nghiệp có thể cải thiện thông lượng và độ trễ phản hồi của hệ thống.
Thay đổi 3: AI Data Center trở thành hệ thống tính toán tích hợp
Data Center truyền thống thường được tổ chức thành các nhóm tài nguyên compute, storage và network phục vụ nhiều ứng dụng khác nhau.
Trong các hệ thống AI quy mô lớn, ba nhóm tài nguyên này cần phối hợp chặt chẽ hơn để đáp ứng nhu cầu huấn luyện và suy luận.
Xu hướng AI Factory thể hiện hướng tiếp cận đó: thiết kế toàn bộ hạ tầng như một hệ thống sản xuất và cung cấp năng lực AI liên tục.
NVIDIA và AMD đều đã giới thiệu các giải pháp rack-scale trong năm 2026, phản ánh xu hướng tối ưu hệ thống ở cấp độ rack và cụm máy chủ.
Thay đổi 4: Lưu trữ và quản lý dữ liệu AI trở nên quan trọng hơn
Bộ nhớ HBM có tốc độ truy cập cao nhưng dung lượng vẫn hữu hạn và chi phí tích hợp lớn.
Vì vậy, các hệ thống AI cần kết hợp nhiều lớp bộ nhớ và lưu trữ, chẳng hạn HBM, RAM hệ thống, SSD NVMe và hệ thống lưu trữ mạng.
Đặc biệt, những ứng dụng AI Agent sử dụng ngữ cảnh dài có thể cần quản lý lượng lớn KV Cache.
Trong năm 2026, NVIDIA đã công bố Inference Context Memory Storage Platform dựa trên BlueField-4 để hỗ trợ mở rộng và chia sẻ dữ liệu ngữ cảnh giữa các hệ thống AI.
Điện năng, làm mát và chi phí sẽ là thách thức lớn
Cùng với sự phát triển của GPU, HBM và mạng tốc độ cao, các hệ thống AI cũng đang đặt ra yêu cầu ngày càng cao đối với cơ sở hạ tầng trung tâm dữ liệu.
Điện năng và làm mát trở thành yếu tố cần tính toán ngay từ đầu
Theo báo cáo Energy and AI của Cơ quan Năng lượng Quốc tế (IEA) công bố năm 2025, điện năng tiêu thụ của các trung tâm dữ liệu toàn cầu có thể tăng lên khoảng 945 TWh vào năm 2030 trong kịch bản cơ sở. Đây là dự báo cho toàn bộ Data Center, không chỉ riêng các trung tâm dữ liệu AI.
Đối với hệ thống AI có mật độ GPU cao, khả năng cung cấp điện và giải nhiệt là những yếu tố cần được đánh giá từ giai đoạn thiết kế.
Các nền tảng AI quy mô lớn đang hướng đến những giải pháp như làm mát bằng chất lỏng, quản lý điện năng ở cấp rack và tối ưu hệ thống phân phối điện.
Chẳng hạn, NVIDIA Vera Rubin hỗ trợ kiến trúc làm mát bằng chất lỏng cho hệ thống mật độ cao.
Chi phí đầu tư AI cần được đánh giá theo TCO
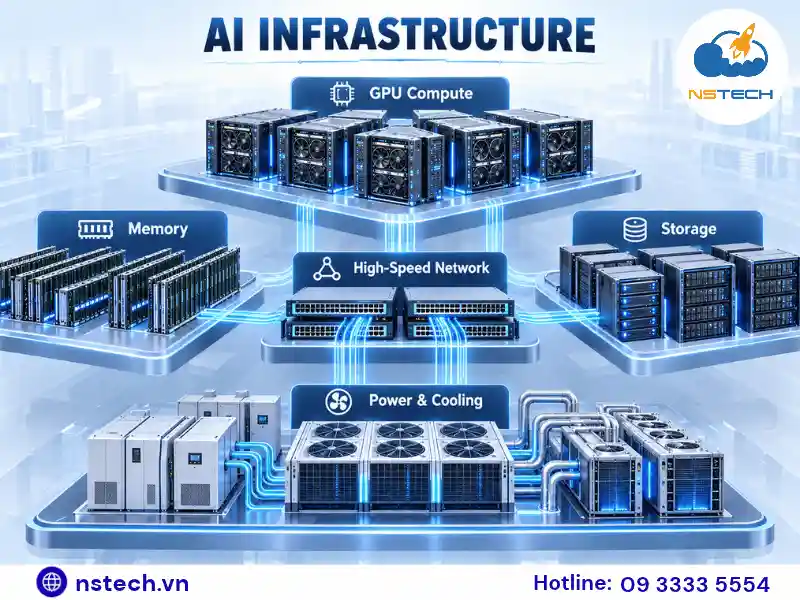
Tổng chi phí sở hữu (Total Cost of Ownership – TCO) của hạ tầng AI bao gồm nhiều yếu tố hơn giá mua GPU.
Doanh nghiệp cần xem xét chi phí phần cứng, bộ nhớ, mạng, lưu trữ, điện năng, làm mát, bản quyền phần mềm, nhân sự vận hành và bảo trì.
Một hệ thống có hiệu năng tính toán lý thuyết cao chưa chắc có TCO phù hợp nếu tài nguyên không được khai thác hiệu quả.
Vì vậy, việc đầu tư AI Server trong giai đoạn 2026–2030 nên dựa trên hiệu quả thực tế của khối lượng công việc, khả năng mở rộng và chi phí vận hành dài hạn.
Tương lai hạ tầng AI không chỉ nằm ở sức mạnh GPU
Giai đoạn 2026–2030 có thể chứng kiến những thay đổi đáng kể trong cách xây dựng và vận hành hạ tầng AI.
GPU tiếp tục nâng cao năng lực tính toán, bộ nhớ HBM mở rộng khả năng truy cập dữ liệu, trong khi mạng tốc độ cao giúp nhiều bộ xử lý phối hợp hiệu quả hơn.
Tuy nhiên, những thành phần này chỉ phát huy giá trị khi được kết hợp trong một kiến trúc phù hợp với ứng dụng.
Điều quan trọng là xác định đúng nhu cầu, lựa chọn cấu hình cân bằng giữa GPU, bộ nhớ, mạng và lưu trữ, đồng thời bảo đảm khả năng mở rộng và hiệu quả vận hành lâu dài.
NSTECH cung cấp các giải pháp máy chủ và hạ tầng CNTT cho doanh nghiệp. Nếu đang lên kế hoạch triển khai AI Server, nâng cấp GPU Server hoặc xây dựng hạ tầng phục vụ LLM và Generative AI, doanh nghiệp có thể liên hệ NSTECH để trao đổi nhu cầu và được tư vấn cấu hình phù hợp.
Website: https://nstech.vn/
Hotline: 09 3333 5554
Email: ducnh@nstech.vn
Văn Phòng TPHCM: 419/2N Phan Xích Long, Phường Đức Nhuận, Tp.Hồ Chí Minh
Văn Phòng Hà Nội: Tầng 6 Số 95 Phố Hoàng Cầu, Phường Đống Đa, Thành phố Hà Nội
Văn Phòng Đà Nẵng: Số 36 đường Nguyễn Cư Trinh, Phường Hòa Cường, TP Đà Nẵng
Tôi là Hoàng Đức – CEO Công ty Cổ phần NSTECH Việt Nam. Với nhiều năm kinh nghiệm trong lĩnh vực hạ tầng máy chủ và giải pháp công nghệ, tôi định hướng NSTECH không chỉ là đơn vị cung cấp thiết bị, mà là đối tác chiến lược giúp doanh nghiệp xây dựng nền tảng IT ổn định, an toàn và bền vững.
CHIA SẺ BÀI VIẾT